Детский рисунок ожил в ИИ-видео и стал семейным хитом
Анимация детского рисунка нейросетью работает на простом контрасте: на экране появляется знакомая каракуля, а через секунду она уже двигает руками, шагает или превращается в реалистичного персонажа. Для семьи это короткий эффект узнавания.
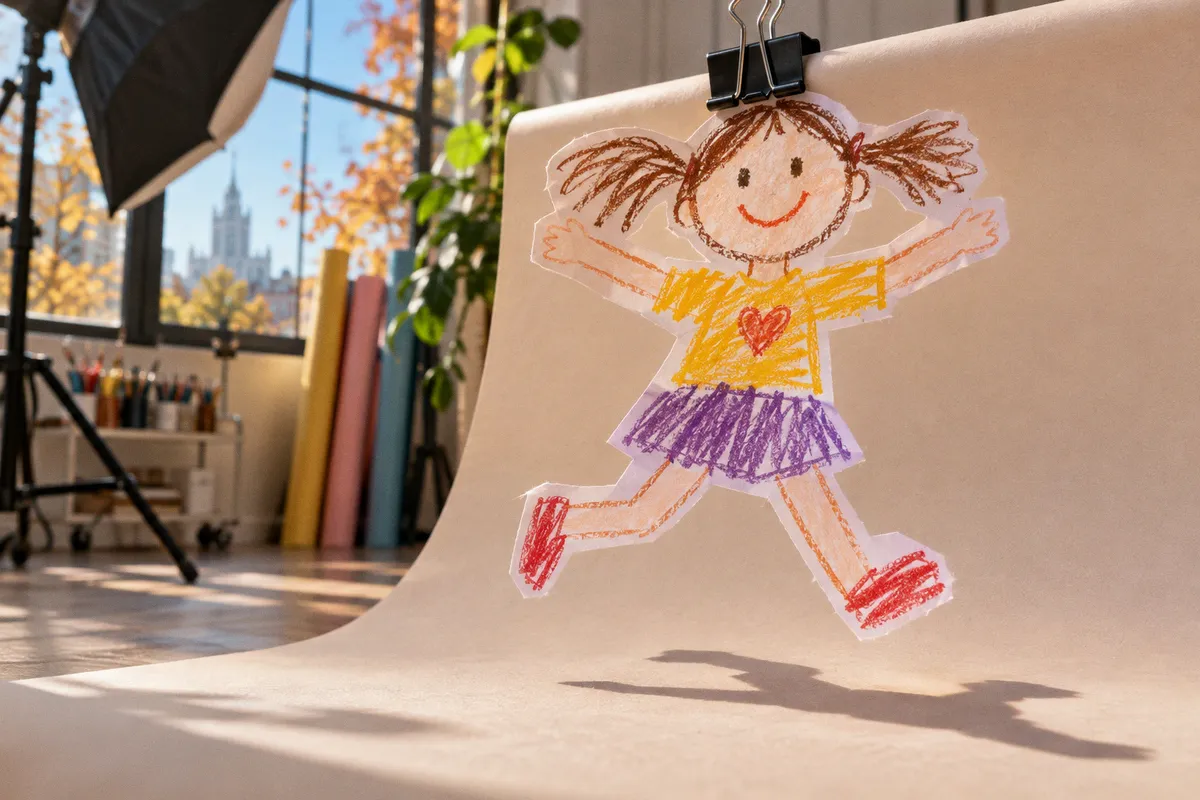
Для алгоритма — задача распознать фигуру, отделить её от фона и решить, какие части изображения должны двигаться.
Под одним вирусным форматом скрываются разные технологии. Одни инструменты анимируют плоского нарисованного персонажа, стараясь удержать его исходный вид. Другие используют рисунок как основу для нового изображения, а затем создают ролик. Поэтому результат может выглядеть эффектно, но не всегда сохраняет именно тот рисунок, который ребёнок положил перед камерой.
Почему семейный эксперимент хорошо работает в соцсетях
Детский рисунок обычно узнаваем для его автора и семьи, даже если посторонний зритель не сразу понимает, что именно изображено. ИИ добавляет к этому личному смыслу движение. Если у персонажа вдруг шевелится рука или он делает шаг, статичная картинка становится маленьким событием.
В коротком видео считывается понятная последовательность: сначала зрителю показывают исходный лист, затем его цифровую версию. Между ними — заметное превращение. Такому ролику не требуется длинное объяснение, а семейная реакция становится частью контента. Именно сочетание личного объекта и мгновенного визуального эффекта делает формат удобным для публикации и пересылки.
Однако популярность механики сама по себе не говорит, каким именно сервисом создан конкретный ролик. В доступных материалах нет надёжно подтверждённой идентификации автора и рабочего процесса для семейного видео, обсуждаемого в связи с этим трендом. Узнаваемый результат не позволяет восстановить использованную модель: разные инструменты могут давать похожую картинку.
Есть и более техническая причина, по которой ролик воспринимается как превращение. Нейросеть не просто накладывает движение на пиксели. В зависимости от метода она либо пытается понять структуру нарисованного персонажа, либо создаёт новый образ по исходному изображению. В первом случае результат чаще сохраняет плоский стиль. Во втором рисунок может стать лишь отправной точкой для реалистичной интерпретации.
Вирусный эффект строится на личном узнаваемом рисунке, а технический результат зависит от того, что именно система считает персонажем.
Два разных способа оживить рисунок
Запрос «оживить детский рисунок ИИ» объединяет как минимум два принципиально разных сценария. Это важно учитывать до загрузки изображения: пользователь может ожидать, что нарисованный человечек начнёт двигаться, а получить реалистичного героя, который лишь отдалённо напоминает оригинал.
Плоская анимация: система ищет части персонажа
В подходе, описанном Meta для Animated Drawings, алгоритм сначала обнаруживает человекоподобную фигуру. Затем отделяет её от фона, определяет суставы и применяет выбранное движение. Получается попытка анимировать исходного персонажа, сохранив его нарисованным.
В процессе можно поправить рамку вокруг фигуры, маску сегментации и положение суставов. Это не декоративные настройки. Если рамка захватила кусок стола или маска срезала край руки, система будет работать с неверно выделенным объектом. Если сустав оказался не там, где начинается нога, движение может выглядеть странно даже при корректно выбранной анимации.
Публичная демонстрация Animated Drawings была запущена в декабре 2021 года. В научной статье о системе также описан датасет более чем из 178 000 любительских рисунков. Сам факт большого набора данных не означает, что модель одинаково хорошо понимает любую детскую картинку: в статье отдельно отмечено, что абстрактность и разнообразие рисунков усложняют распознавание.
Генеративное видео: рисунок становится основой новой сцены
Другой сценарий начинается с изображения, но допускает более серьёзное переосмысление. Коммерческая страница RapVideo описывает эффект, при котором фотографию рисунка преобразуют в реалистичный образ, а затем получают короткий ролик. Для этого конкретного эффекта указаны пять секунд видео, разрешение 720p и стоимость четыре кредита. Эти параметры относятся к описанию одного сервиса, а не к нейросетевой анимации в целом.
Исследовательская система FairyGen использует иной процесс: исходный рисунок персонажа становится основой для раскадровки, фоновых сцен и многокадрового мультфильма. Среди описанных этапов — создание 3D-прокси персонажа и применение модели генерации видео. Такой конвейер работает с более широким контекстом, чем простое движение уже выделенной фигуры.
| Подход | Что делает система | Что может измениться |
|---|---|---|
| Анимация плоского персонажа | Выделяет фигуру, оценивает суставы и задаёт движение | Положение конечностей, контур и отдельные детали при ошибке распознавания |
| Генерация нового образа и видео | Интерпретирует рисунок, создаёт визуальную версию персонажа и анимирует её | Стиль, пропорции, фактура, фон и мелкие элементы исходника |
| Многокадровая генерация | Использует персонажа для построения последовательности сцен | Внешность между кадрами и соответствие сцен первоначальному замыслу |
Выбор между вариантами — это выбор степени вмешательства. Плоская анимация ближе к исходному листу, если система правильно поняла фигуру. Генеративный ролик может дать более зрелищный образ, но при этом сильнее отойти от рисунка. Универсальной настройки, которая гарантирует одновременно точное сохранение почерка и сложную анимацию, приведённые материалы не подтверждают.
Что происходит между фотографией и движением
В плоском сценарии критическая часть работы происходит до анимации. Система должна найти границы персонажа, отделить его от фона и определить, какие участки изображения соответствуют голове, рукам и ногам. Затем поверх этого понимания строится движение.
Для изображения, похожего на человечка с отчётливыми конечностями, задача относительно ясна. Абстрактная фигура с несколькими пересекающимися линиями может не дать алгоритму однозначного ответа. Даже человек не всегда согласится, где у рисунка локоть или какая линия обозначает ногу. Модель тем более не обладает семейным контекстом и не знает, что ребёнок имел в виду.
В демонстрации Meta пользователь может вручную корректировать три элемента:
1. Рамку фигуры. Она задаёт область, которую система считает персонажем. Слишком тесная рамка обрежет детали, слишком широкая захватит фон.
2. Маску сегментации. Она определяет, какие пиксели принадлежат персонажу. Ошибка здесь может привести к исчезновению части рисунка или включению в анимацию постороннего объекта.
3. Положение суставов. Оно влияет на то, как фигура будет сгибаться и двигаться. Для условного человечка неправильная точка крепления конечности заметна сразу.
Эти поправки объясняют, почему результат не всегда сводится к кнопке «оживить». Автоматическая обработка должна угадать структуру изображения; пользователь может вмешаться, если догадка не совпала с рисунком. Для короткого ролика это небольшой этап, но он влияет на то, будет ли движение выглядеть связным.
При генерации реалистичной версии набор проблем меняется. Система может не пытаться восстановить суставы в исходном рисунке, зато ей нужно придумать объём, текстуру и детали, которых на листе нет. Если на рисунке изображён персонаж из нескольких кругов и линий, реалистичный образ неизбежно содержит интерпретацию. Нейросеть заполняет пробелы вероятными для неё деталями, а не извлекает из рисунка скрытую «правильную» версию.
Почему рисунок меняется после обработки
Ожидание точного переноса часто расходится с тем, как устроена генерация. Рисунок служит входным изображением, но не обязательно становится жёстким шаблоном для каждого кадра. Модель может сгладить неровные линии, перестроить пропорции или изменить расположение деталей. Чем свободнее генеративный процесс, тем больше пространства для такого переосмысления.
Это особенно заметно в рисунках с намеренно необычной анатомией или собственным визуальным почерком. Если у персонажа очень длинные руки, асимметричные глаза или голова непривычной формы, система может нормализовать эти особенности. Для алгоритма они выглядят как шум или ошибка; для автора рисунка могут быть главными деталями образа.
Материал TechRadar также отмечает непостоянство результатов и риск сглаживания индивидуального стиля. В качестве практического ориентира там предлагается отдельно задавать сохранение силуэта, пропорций, расположения деталей и цветового замысла. Это не гарантия: формулировка промпта помогает обозначить приоритеты, но не превращает генеративную модель в инструмент точного копирования.
Перед загрузкой полезно решить, какая часть рисунка должна пережить преобразование. Для одного ролика важнее сохранить силуэт, для другого — цвета или выражение лица. Чем конкретнее задача, тем проще оценить результат: например, персонаж должен оставаться плоским, его пропорции не должны меняться, фон нужно оставить нейтральным. Но даже детальный промпт не отменяет ограничений модели.
Следует различать два вида ошибки. В первом случае система неверно распознала исходную фигуру: маска обрезала руку, сустав поставлен неудачно, фон включён в объект. Во втором она распознала изображение, но затем изменила его в процессе генерации. Настройки сегментации могут помочь с первым случаем. Для второго нужны ограничения на стиль и детали, а полного совпадения всё равно нельзя считать гарантированным.
Откуда взялись 7,8 млн просмотров
В материалах, найденных по теме, коммерческая страница RapVideo утверждает, что публикация с детскими рисунками и их ИИ-версиями набрала 7,8 млн просмотров к 4 ноября 2026 года. Независимо проверить эту цифру по доступной статистике TikTok не удалось. Также не установлено, какой именно пост стал первым вирусным примером и кто создал обсуждаемое семейное видео.
Страница была обновлена 4 ноября 2026 года, до даты подготовки этого материала, 22 ноября 2026 года. Однако заявленную метрику всё равно нельзя подавать как независимо подтверждённую: её корректно рассматривать как число, опубликованное коммерческим сервисом, а не как проверенную статистику платформы.
Это различие важно для самого сюжета. Просмотры одного ролика не доказывают, что тренд начался именно с него, а описание похожего эффекта на странице сервиса не подтверждает, что этот сервис использовал автор конкретной публикации. Для такой связи потребовались бы исходный пост, данные о его создателе и подтверждение рабочего процесса. В доступных фактах этого нет.
Цифра всё же объясняет, почему формат обсуждают: превращение рисунка в движущегося персонажа легко показать в одном коротком видео. Но масштаб вирусности и происхождение тренда остаются отдельными вопросами. Их нельзя закрыть одним коммерческим описанием или совпадением визуального эффекта.
Что остаётся от рисунка после ИИ
Нейросеть для анимации рисунков может быть полезна как быстрый способ получить движение из статичного изображения. Но термин охватывает инструменты с разной логикой: от распознавания суставов в плоской фигуре до генерации реалистичного персонажа и последовательности сцен. Перед запуском стоит понимать, какой из этих результатов нужен.
Если задача — сохранить детский рисунок, разумнее оценивать не только плавность движения, но и то, что осталось неизменным: силуэт, пропорции, цвет и расположение деталей. Если важен зрелищный ролик, генеративный вариант может дать больше визуального эффекта, однако он заметнее интерпретирует исходник.
Именно в этом и состоит реальная польза формата. Он быстро превращает личный рисунок в короткое видео, которое семья может показать другим. Точность этой трансформации зависит от изображения, выбранного метода и вмешательства пользователя. Заявленные миллионы просмотров пока требуют отдельной проверки, а обещание полностью сохранить детский почерк стоит воспринимать как пожелание, не как техническую гарантию.