Генерация картинки по тексту: почему ИИ рисует кошмары вместо мечты
«Просто опишите свою идею — и нейросеть создаст шедевр за секунды». Такие обещания часто сопровождают генераторы изображений, но результат не всегда совпадает с замыслом: у человека может оказаться…
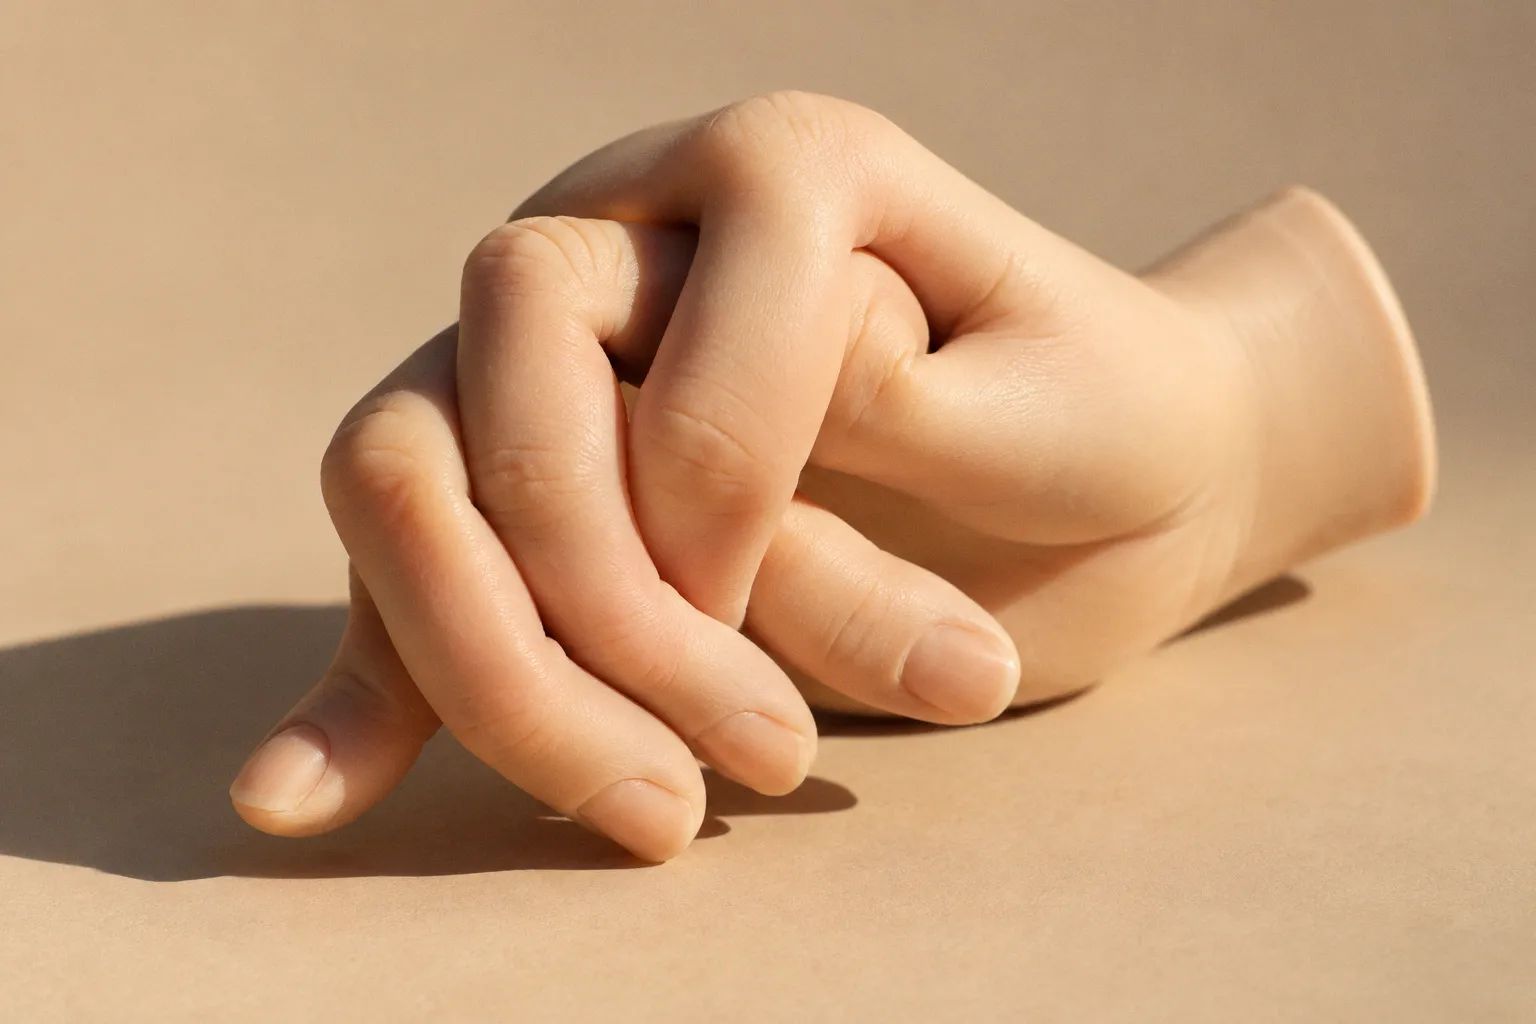
«Просто опишите свою идею — и нейросеть создаст шедевр за секунды». Такие обещания часто сопровождают генераторы изображений, но результат не всегда совпадает с замыслом: у человека может оказаться лишний палец, вывеска — превратиться в набор псевдобукв, а рука — странно срастись с предметом. Хайп вокруг генерации картинок по тексту легко заслоняет простую вещь: модель не понимает сцену так, как понимает её человек. Она строит изображение на основе закономерностей, усвоенных из данных.
Поэтому ошибки — не просто досадные сбои, которые можно раз и навсегда вычеркнуть удачной формулировкой промпта. Это побочный эффект способа, которым работает генерация: текст задаёт направление, а модель подбирает визуальное решение. Иногда убедительно. Иногда — с таким результатом, что хочется проверить, не стало ли изображение ещё одной вирусной страшилкой из ленты.
Статистика против логики: почему нейросети не знают анатомии
Генераторы вроде Midjourney, Stable Diffusion, DALL-E и Шедеврума не обязательно строят внутри себя точную трёхмерную модель человеческого тела. Они учатся связывать изображения с текстовыми описаниями и воспроизводить визуальные закономерности из обучающих данных. Модель может часто видеть слово «рука» рядом с характерными очертаниями кисти, но это не то же самое, что знать правила анатомии и применять их как человек.
Отсюда знакомая путаница с пальцами, суставами и тем, как кисть соединяется с предплечьем. В изображениях руки бывают закрыты рукавами, предметами или другими людьми, сняты под разными углами, частично обрезаны кадром. Модель должна собрать целостную форму из разнообразных примеров, но не всегда располагает достаточным контекстом, чтобы выбрать правдоподобный вариант.
Здесь есть важное уточнение: генераторы не все устроены одинаково, и их возможности не сводятся к одной универсальной схеме. Но даже модели, которые хорошо передают общий вид сцены, могут ошибаться в деталях. Убедительная картинка ещё не означает, что алгоритм последовательно понимает, какие предметы на ней изображены и как они должны взаимодействовать.
Нейросеть может убедительно показать руку, не «зная» её устройства. Она воспроизводит визуальные закономерности — а не проверяет результат по анатомическому справочнику.
Именно поэтому артефакты часто выглядят не случайным шумом, а почти правдоподобной ошибкой: пальцы сливаются, суставы оказываются не на месте, предмет будто проходит сквозь ладонь. Модель не ставит себе задачу сверить каждый элемент с физическим миром. Её задача — создать изображение, которое соответствует запросу и визуальным шаблонам, усвоенным при обучении.
Эффект зловещей долины: откуда берутся пугающие артефакты
Чем ближе изображение к фотореализму, тем сильнее зритель замечает мелкие несоответствия. Стилизованный персонаж может иметь условные черты — мы считываем их как часть художественного решения. А у почти реалистичного лица неправильное положение глаза или странная улыбка сразу бросаются в глаза. Так возникает ощущение, что изображение одновременно знакомое и неправильное. С этим часто связывают эффект зловещей долины — понятие из робототехники, которое применяют и к искусственным изображениям.
Не всякая асимметрия лица выглядит пугающе: естественная асимметрия есть у живых людей. Тревожит скорее сочетание деталей, которые плохо согласуются друг с другом: один глаз смотрит в сторону, а второй — прямо; улыбка не совпадает с выражением остального лица; кожа выглядит как пластик, хотя освещение и текстура претендуют на фотографическую достоверность.
К типичным ошибкам при генерации изображений ИИ относятся:
- лишние или сросшиеся пальцы, особенно в сложном ракурсе;
- псевдотекст на вывесках, одежде и страницах книг;
- тени, которые не согласуются с положением источника света;
- предметы, проходящие сквозь руки или сливающиеся с мебелью;
- мелкие черты лица, которые выглядят неестественно именно в фотореалистичном изображении.
Не каждый такой дефект обязательно появляется из-за одной и той же причины. На результат влияют и обучающие данные, и композиция, и формулировка запроса, и особенности конкретной модели. Но зритель обычно замечает общий эффект: картинка обещает реализм, а затем нарушает его в одной детали. Чем убедительнее всё остальное, тем заметнее сбой.
Стилизация здесь может работать как страховка. В рисунке, коллаже или фантастической иллюстрации зритель заранее понимает, что перед ним не фотография. Условности воспринимаются спокойнее, а небольшая неточность не так быстро превращает лицо в источник тревоги. Фотореализм, напротив, поднимает планку ожиданий: от изображения ждут физически связной сцены, и любая ошибка становится частью впечатления.
Проблема пяти пальцев и другие ловушки обучающих датасетов
Кисти рук — не единственная сложность, но на них хорошо видно, как обучающие данные влияют на результат. В реальных изображениях руки часто частично закрыты, обрезаны краем кадра, размыты движением или сняты под неудобным углом. Полная кисть на ясном фоне — лишь один из множества вариантов. Модели приходится учиться на примерах, которые дают неодинаковую и порой неполную информацию.
Если в запросе одновременно есть несколько людей, предметы в руках, сложные жесты и тесная композиция, задача становится труднее. Модели нужно не просто нарисовать каждую руку, но и определить, кому она принадлежит, где заканчивается одна фигура и начинается другая, что именно человек держит. Ошибка в одном месте может потянуть за собой соседние детали.
Текст на изображениях устроен иначе, но проблема похожа. Многие генераторы хорошо передают общий вид надписи — вывеску, заголовок, логотипоподобную форму, — однако конкретные буквы и их порядок могут искажаться. В таком случае модель создаёт не обязательно осмысленный текст, а визуальный рисунок, похожий на текст. Для плаката это может быть заметным браком; для размытого фона — несущественной деталью.
У этих затруднений нет одной волшебной причины и универсального решения. Дополнительные примеры и улучшение методов обучения способны повысить качество, но не гарантируют безошибочного изображения в любой сцене. Заметный прогресс в генераторах не означает, что исчезли случаи, где важно точно совместить мелкие детали, сложные позы и несколько объектов.
Чем сложнее взаимодействуют предметы и части тела в кадре, тем меньше шансов, что модель угадает каждую связь с первого раза.
Это стоит учитывать ещё до генерации. Если критично показать конкретный жест, украшение на пальце или точную надпись, не стоит рассчитывать только на удачный текстовый запрос. Иногда проще сгенерировать основу, а затем исправить нужную область инструментами редактирования или вручную. Генерация по описанию — не всегда кнопка «сделай готово»; нередко это способ получить заготовку для дальнейшей работы.
Искусство управления: как негативные промпты спасают от брака
Лучшие нейросети для текстовых запросов дают пользователю разные способы уточнить результат. Один из них — негативный промпт: указание на то, чего на изображении быть не должно. В Midjourney для этого используют параметр --no, а в интерфейсах Stable Diffusion может быть отдельное поле negative_prompt.
Запрос вроде --no extra fingers, mutated hands, blurry text помогает обозначить нежелательные детали. Но он не работает как гарантия и не исправляет любое изображение автоматически. Если сцена сложная или сам основной промпт противоречив, модель всё равно может выдать артефакт. Негативное описание полезнее воспринимать как дополнительное направление для генерации, а не как команду, которой алгоритм обязан подчиниться буквально.
Как составить промпт для нейросети, чтобы снизить вероятность брака? Начать стоит не с длинного перечня запретов, а с ясного описания сцены:
1. Сформулируйте главное действие и расположение объектов. Чем понятнее, кто что делает и где находится, тем меньше модель заполняет пробелы догадками.
2. Уточните важные детали. Если нужны хорошо видимые руки, обозначьте, что они находятся в кадре и не закрыты предметами. Если критична вывеска, укажите, какой именно текст должен быть на ней.
3. Назовите стиль и ракурс. Крупный план кистей на спокойном фоне — более управляемая задача, чем руки среди нескольких персонажей в сложной сцене.
4. Добавьте негативные условия для частых ошибок, но не перегружайте ими запрос. Список запретов не заменяет ясную постановку задачи.
5. Сравните несколько вариантов и отредактируйте лучший. Даже аккуратная формулировка не делает результат предсказуемым до последнего пикселя.
Уточнения полезны, когда помогают модели понять приоритеты. Если промпт требует сразу фотореалистичную сцену, сложный жест, точную надпись, необычное освещение и множество мелких объектов, модель может уделить внимание одному и потерять другое. Иногда выигрышнее разделить задачу: сначала добиться нужной композиции, затем отдельно улучшить детали.
Это уже не столько магия слов, сколько работа с ограничениями инструмента. Пользователь задаёт направление, оценивает результат и решает, где достаточно удачного варианта, а где нужна доработка.
Эволюция моделей: от хаотичных набросков до фотореализма
Ранние генерации быстро стали мемами из-за заметных ошибок в руках, лицах и тексте. С развитием моделей стало проще получить цельную композицию и убедительный общий вид, а часть привычных дефектов возникает реже. Но это не значит, что генераторы перестали ошибаться: заметные проблемы переместились в детали, которые раньше терялись за общей неубедительностью изображения.
Сегодня результат зависит не только от названия модели. Важны версия и настройки, содержание запроса, сложность сцены и то, насколько хорошо обучающие данные покрывают нужный случай. Одна система может лучше справляться с текстом, другая — с определённой стилистикой или композицией. Универсального победителя для любых задач нет.
| Подход | Что обычно получается лучше | Где стоит ждать ошибок |
|---|---|---|
| Стилизованная иллюстрация | Общий образ и выразительная композиция | Мелкие детали и точная форма предметов |
| Фотореалистичная сцена | Свет, фактуры и впечатление фотографии | Лица, кисти и предметы в сложном взаимодействии |
| Изображение с надписью | Общее расположение текста и визуальный стиль вывески | Точные буквы, длинные фразы и мелкий шрифт |
| Многофигурная композиция | Атмосфера и общий сюжет | Переплетение рук, принадлежность предметов и детали на заднем плане |
Таблица — не рейтинг моделей, а напоминание о том, что задачи отличаются. Если нужен постер с короткой фразой, важнее проверить точность текста. Если в центре кадра руки, стоит отдельно рассмотреть их форму и положение. Когда критична сложная сцена с несколькими персонажами, полезнее оценивать не только красоту картинки, но и то, насколько связно устроено происходящее.
Создание арта через промпт остаётся итеративным процессом: описать, посмотреть, уточнить, отобрать. Рост качества не отменяет этой последовательности. Модель может стать лучше в создании реалистичных лиц, но при этом ошибиться в отражении или переплетённых пальцах — именно потому, что убедительность целого и точность каждой детали не всегда растут одинаково.
Не магия, а инструмент с характером
Как нейросеть рисует по описанию, зависит от устройства конкретной системы. Многие современные генераторы используют диффузионные подходы, но не все генераторы изображений устроены одинаково, поэтому сводить их к одной архитектуре неверно. Общая идея текстового управления при этом проста: описание помогает модели выбрать направление, а результат формируется на основе усвоенных визуальных связей. Это не человеческое понимание сцены и не гарантия физической точности.
Поэтому лучше оценивать генерацию не по обещанию нарисовать что угодно, а по тому, насколько хорошо конкретная модель решает конкретную задачу. Для мемов, черновых концептов и иллюстраций, где важнее настроение, чем точность каждой детали, она может сэкономить время и открыть неожиданные варианты. Если нужна безошибочная анатомия, точный текст или строго заданное взаимодействие объектов, изображение придётся внимательно проверять и, возможно, дорабатывать.
Генерация картинки по тексту стала доступнее, но доступность не равна предсказуемости. Нейросеть умеет превращать описание в изображение — иногда впечатляющее, иногда странное. И чем точнее мы понимаем её сильные стороны и слепые зоны, тем реже лишний палец оказывается сюрпризом, а тем больше шансов получить из генерации действительно полезный материал.